使用Weight-Space Programming将Qwen3.5-0.8B调整为特定口调
Weight-Space Programming を試す - Qwenをずんだもん口調にする
我尝试使用「Weight-Space Programming」将 Qwen 调整为ずんだもん(Zundamon)的说话风格,并对此进行了总结。
目次
- 1. 前言
- 2. 什么是 Weight-Space Programming
- 3. 本次实验的目标
- 4. 数据集的准备
- 4-1. 观察用数据集(60组)
- 4-2. 候选选择用数据集(30题)
- 4-3. 最终评估用数据集(50题)
- 5. 权重编辑步骤
- 5-1. 准备常规语气和目标语境的上下文
- 5-2. 检查内部状态的差异
1. 前言
在题为「尝试一下 Weight-Space Programming(让我试了一下)」的文章中,介绍了通过直接重写 Qwen 的权重来使其具备ずんだもん口调的实验。
因此,我也参考了该文章的方法,使用 Codex 进行了类似的实验。
2. 什么是 Weight-SSpace Programming
「Weight-Space Programming」是一种让 AI 检查模型内部并直接重写“权重”以使其产生目标行为的方法。
权重是模型中保存的大量数值。模型利用这些数值来处理文本,并决定接下来要输出的词语。
比较改变口调的方法,如下所示:
・提示词(Prompt):指示“请用ずんだもん的口调回答”。
・追加学习(Fine-tuning):通过更新权重以减少与示例回答之间的误差。
・Weight-Space Programming:由编辑用的 AI 检查内部,设计权重的修改。
追加学习也会改变权重。不同之处在于确定要修改的数值的方式。
3. 本次实验的目标
本次目标是,编辑 Qwen3.5-0.8B,打造无需指示口调也能以「のだ/なのだ」自然回答的模型。
编辑前:日本的货币是「日元」。
编辑后:日本的货币是「日元」なのだ。
对 Codex 的指示如下。
使用 Weight-Space Programming 方法
将 Qwen3.5-0.8B 调整为「ずんだもん口调」
此外,以下是本次 Codex 所采用的方法,并非在「Weight-Space Programming」中总是执行相同的处理。
4. 数据集的准备
本次未使用公开数据集,而是让 Codex 生成了问题和回答示例。
数据集按用途分为“观察用”、“候选选择用”和“最终评估用”三类。
4-1. 观察用数据集(60组)
用于调查不同语气对模型内部状态影响的数据。
准备了通常语气与ずんだもん语气的回答共60组。
问题:水冻结后变成什么?
・通常语气:水冻结后变成冰。
・目标语气:水冻结后变成冰的。
每个数据都记录了问题、句子类型、两个回答以及直到词尾分岔之前的共同部分。
本例中的共同部分是“水结冰的东西是冰”。我们在不同语气的语境中处理相同的回答,并考察词尾前后内部状态的变化。
此外,为了处理自然的词尾连接,我们将句子分为三类。
・名词句:20组
“是冰。”→“是冰啊。”
・动词句:20组
“洗手。”→“要洗手啊。”
・い形容词句:20组
“糖是甜的。”→“糖是甜啊。”
如果直接在名词后加上“のだ”,会变成“冰的”这样不自然的句子,因此我们按句子类型分别考察差异。
4-2. 候选选择用数据集(30题)
用于从权重编辑候选中选择最佳选项的数据。
准备了30道关于知识、计算和日常生活的问题。
・日本的首都是哪里?
・一天有多少小时?
・请简短说明给花浇水的理由。
・辣椒是什么味道?
让各个候选模型回答问题,并自动检查以下项目。
・句尾是否为「のだ/なのだ」
・是否存在不自然的连接或重复
・回答是否被中途截断
・是否包含正确答案关键词
正确答案关键词设置为如“东京”等答案明确的问题。不过,仅凭关键词无法判断整个回答的正确性,因此将其作为简易评估使用。
4-3. 最终评估用数据集(50题)
用于确认所选模型编辑效果的数据。
除了候选选择用之外,还准备了50道题。
・日本的货币单位是什么?
・一个半小时是多少分钟?
・八乘以七等于多少?
・请告诉我睡前避免使用手机的一个理由。
这50道题是在确定候选之后执行,查看结果后不再重新选择。
此外,三个数据集虽然问题文本不同,但可能包含相似的主题或知识。
5. 权重编辑步骤
5-1. 准备一般语气和目标语境的上下文
首先,我为模型准备了三种上下文。
・仅一般指示
・一般指示+一般语气的回答示例8组
・一般指示+语气指定+目标语气的回答示例8组
一般指示如下文所示。
你是一个乐于助人的助手。
请用日语简洁地回答。
在目标语境的上下文中,添加了以下指示。
回答的句末请务必使用「のだ」或「なのだ」。
请以自然的日语ずんだもん语气进行回答。
从用于观察的60组中选取了8组回答示例,其中包括名词句3组、动词句3组、い形容词句2组。
5-2. 探究内部状态的差异
在三种语境中,分别让模型阅读观察对象的回答。
在本次实现中,向观察对象输入相同目标语气的回答,并比较由前置指示和回答示例引起的内部状态差异。
语境A:普通语气的回答示例
观察对象:水结冰后就是冰。语境B:Zundamon语气的指令与回答示例
观察对象:水结冰后就是冰。
记录的是词尾前后、句号之后、回答开始前以及回答过程中的内部状态。
词尾前后的变化用作语气调整的线索,其余部分则用于抑制对不必要场景的影响。不进行计算与正确答案误差的学习,而是观察处理过程中的数值。
5-3. 计算权重的变更量
在普通语气和目标语气的语境下计算内部状态的差异,并对大量样本取平均值。将该差异作为向Zundamon语气靠拢的方向使用。
但是,如果在文章中间也始终添加该方向,可能会导致输出损坏。因此,我们进行了修改,使其在句尾处产生反应,而在正文中间等处抑制反应。
所做的修改共有以下四项:
・作用于名词句末尾之前的修改
・作用于动词句末尾之前的修改
・作用于い形容词句末尾之前的修改
・作用于输出句尾之后产生的修改
句尾之后的修改旨在减少在“のだ”之后仍不自然地继续续写句子的行为。但是,并不能保证对所有输入都能按预期工作。
5-4. 选择编辑的位置与强度
具体更改哪些位置,并非一开始就确定好的。
本次针对第16、20和24号块,连同变更强度在内比较了9种候选方案。
・在用于候选选择的30题中选取10题来比较9种候选。
・在全部30题中比较排名前两位的候选。
・保存表现最佳的候选。
最终,在第20号块的MLP权重矩阵(down_proj.weight)上添加了制作的4种差异之一。
编辑后的权重 = 原始权重 + 制作的差异
变更的数值约占整个文本模型的0.486%。不过,变更集中在一个权重矩阵上。我们还确认,其余319个权重张量在相同的保存精度下未被修改。
5-5. 评估编辑后的模型
使用最终评估用的50道题对保存的模型进行了评估。
此时去掉了语气指定和回答示例,仅使用通用指令。用同样的50道题在以下三种条件下进行了比较:
・未编辑
・未编辑+语气指定
・权重编辑后
生成条件也保持一致,禁用了思考功能,最大生成为96个token。
6. 実験結果
编辑之后,即使不指定语气,也会得到如下回答。
问题:日本的货币单位是什么?
回答:日本的货币是“日元”。
另一方面,存在语气自然但内容错误的例子。
问题:使用1000日元到300日元后剩余多少?
回答:从1000日元中支付300日元,剩余的是1000日元。
“のだのだ”这种重复以及不自然的连接也仍然存在。
50道题的评估结果如下。
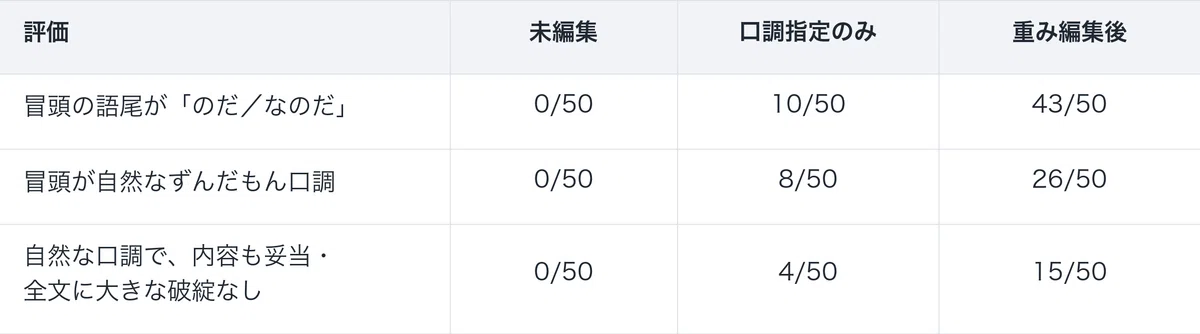
在编辑后模型的50道题评估中,以“のだ/なのだ”结尾的回答占86%,作为日语自然的回答占52%,包括内容在内的正确回答占30%。
自然度和内容是由Codex阅读全文后判定的。这不是由独立人类进行的评估,而是自制的测试。
由于参考文章的问题和评估标准不同,无法简单比较成功率。此外,“仅指定语气”是基于单一提示词的结果,并非与最佳提示词的对比。
7. 処理時間
运行环境为搭载 M3 Max 芯片、128GB 内存的 MacBook Pro。
用于观察内部状态、编辑权重、比较候选项、生成回答并自动评估的脚本,执行耗时约 2 分 14 秒。
若包含模型下载、脚本编写与修改、确认回答自然度、在 Ollama 中验证运行以及整理步骤等全部流程,整体作业耗时约 16 分钟。这约 16 分钟内已包含脚本的执行时间。
関連
来源:npaka · AI与游戏开发技术 · note.com