Pi 与 OpenCode 中上下文窗口及最大输出尺寸的设置技巧
Pi・OpenCodeのコンテキストサイズと最大出力サイズの設定のコツ
总结了Pi・OpenCode中上下文大小和最大输出大小的设置技巧。
目次
- 1. 前言
- 2. 上下文大小与最大输出大小
- 2-1. 什么是上下文大小
- 2-2. 什么是最大输出大小
- 3. 推荐设置值
- 4. 設定方法
- 4-1. Pi的设置方法
- 4-2. OpenCode的设置方法
- 5. 通过Compaction节省上下文
- 5-1. Pi的Compaction
1. 前言
在「Pi」和「OpenCode」等AI代理框架中,LLM的「上下文大小」与「最大输出大小」的设置至关重要。
人们可能会认为只要设置模型支持的最大值就可以了,但并不是设置得越大性能就一定会提升。特别是在本地LLM中,这会影响内存使用量和响应速度。
本文将介绍在Pi或OpenCode中的推荐设置值以及根据用途进行调整的方法。
2. 上下文大小与最大输出大小
2-1. 什么是上下文大小
“上下文大小”(Context Window)是指LLM一次能够处理的令牌数量上限。
在AI编码代理中,以下信息会被包含在上下文中:
・系统提示(System Prompt):对AI的基本指示
・对话历史:迄今为止的指示和回复
・源代码:读取的文件内容
・工具执行结果:命令的输出或错误日志
・生成的回复:代码、说明或工具调用
例如,即使将上下文设置为64K(65,536个token),也无法将这64K全部用于读取源代码。还需要为生成回复预留空间。
上下文尺寸越大,能够处理的信息越多,但存在以下缺点。
・内存使用量增加:处理长对话会导致KV缓存的使用量增加
・回复速度下降:实际处理的输入越长,Prefill阶段所需的时间就越长
・精度下降的可能性:如果无关信息增多,可能会遗漏重要信息
此外,实际的内存使用量不仅取决于上下文长度,还受模型结构、KV缓存精度、并发数等因素影响。
2-2. 最大输出大小
「最大出力サイズ」(Max Output Tokens)是指LLM在一次响应中可生成的令牌数量上限。
例如,即使将最大输出大小设置为8K,如果代理多次调用工具,它也可以生成超过8K的代码。
因此,并不一定需要将最大输出大小设置得很大。
但是,在Thinking模型中,某些API的内部推理令牌包含在输出限制内。对于推理过程较长的模型,如果输出大小较小,可能在代码生成之前就会达到上限。
3. 推荐设置值
当在Pi或OpenCode中使用本地LLM时,推荐设置值如下。
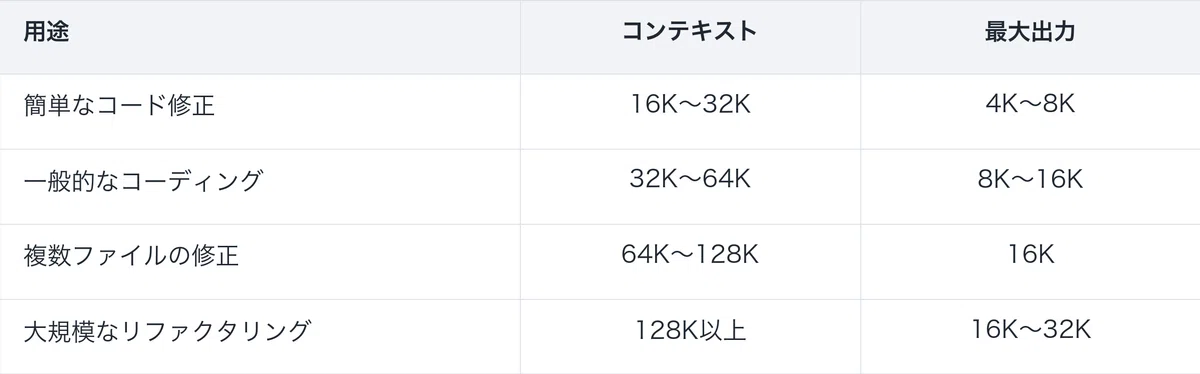
建议以上下文64K、最大输出16K为基准。不过,由于Thinking模型的输出上限可能包含Reasoning令牌,因此可根据需要考虑32K以上。同时,确保模型和推理服务器支持的大小不超过其限制。
contextWindow = 65536
maxTokens     = 16384
ただし、モデルや推論サーバーが対応していることが前提です。メモリに余裕がない環境では、コンテキスト32Kから始めるのがよいでしょう。
4. 設定方法
4-1. Piの設定方法
Piでは、標準対応するクラウドモデルのコンテキストサイズと最大出力サイズは、モデルカタログから自動取得されるため、通常は手動設定不要です。
一方、OllamaやvLLMなどのカスタムモデルでは、「~/.pi/agent/models.json」でモデルを登録し、必要に応じてサイズを指定します。
{
  "id": "your-model-id",
  "contextWindow": 65536,
  "maxTokens": 16384
}・contextWindow:コンテキストサイズ
・maxTokens:最大出力サイズ
省略するとデフォルト値(128K・16K)が使用されます。
4-2. OpenCode 的设置方法
在 OpenCode 2.0 中,可自动检测 Ollama、LM Studio 和 vLLM 的本地模型,因此通常无需手动设置上下文大小或最大输出大小。
对于 Ollama,模型的上下文大小等也会自动获取。若想更改获取到的配置值,可以使用「opencode.json」进行覆盖。
5. 通过 Compaction 节省上下文空间
Pi 和 OpenCode 都具备「Compaction」功能,可在对话历史变长时摘要旧信息。
例如,当 64K 的上下文即将填满时,系统会摘要旧的对话,从而为新的工作腾出可用空间。
5-1. Pi的Compaction
Pi中,可以通过"~/.pi/agent/settings.json"进行设置。
{
  "compaction": {
    "enabled": true,
    "reserveTokens": 16384,
    "keepRecentTokens": 20000
  }
}
・enabled:启用自动Compaction
・reserveTokens:Compaction开始时预留的空闲空间
・keepRecentTokens:不进行摘要而保留的最近历史记录量
这些是官方文档中给出的默认值。
5-2. OpenCode的Compaction
OpenCode也支持自动Compaction。
在OpenCode V2中,可以按如下方式进行设置。
{
  "compaction": {
    "auto": true,
    "keep": {
      "tokens": 15000
    },
    "buffer": "15%"
  }
}
・auto:启用自动Compaction
・keep.tokens:不压缩而保留的最近历史量
・buffer:在Compaction之前预留的上下文余量
由于不同版本的OpenCode配置项有所不同,请查阅您所用版本的文档。
Compaction会对旧对话进行摘要,因此可能会丢失细微的指示或设计决策。将重要规则记录在“AGENTS.md”等文件中会更稳妥。
6. 总结
在Pi或OpenCode中的设置,推荐遵循以下方针。
・上下文大小:默认64K,根据需要可调整为32K〜128K
・最大输出大小:默认16K,根据需要可调整为8K〜32K
・Compaction(压缩):启用自动Compaction
・本地LLM:在监控内存使用量和Prefill速度的同时进行调整
・云端API:基本使用模型的默认设置
重要的是,并非要匹配模型的最大值,而是在确保满足工作所需大小的同时,平衡内存使用量与响应速度。
特别是在Mac或DGX Spark等设备上使用本地LLM时,建议以64K和16K为基准,根据实际工作内容进行调整。
来源:npaka · AI与游戏开发技术 · note.com