Shizuku AI 发布全双工语音对话模型 Shizuku-Duplex
Shizuku-Duplexの概要 と Full-Duplex音声対話モデルの歴史
总结了「Shizuku-Duplex」的概况以及「全双工」语音对话模型的历史。
目次
- 1. 前言
- 2. 什么是 Shizuku-Duplex
- 2-1. 基准测试结果
- 2-2. Shizuku-Duplex 的工作原理
- 3. 什么是全双工语音对话模型
- 3-1. 半双工与全双工
- 3-2. 全双工的机制
- 4. 全双工语音对话模型的历史
- 4-1. 2018年:实现自然语音对话
- 4-2. 2022〜2023年:直接处理语音的语言模型登场
1. 前言
2026年11月,Shizuku AI发布了全双工语音对话模型“Shizuku-Duplex”。
本次将介绍“Shizuku-Duplex”的概要以及“全双工”语音对话模型的机制与历史。
2. 什么是Shizuku-Duplex
2026年11月,开发AI虚拟主播“しずく”的Shizuku AI发布了支持日语的全双工语音对话模型“Shizuku-Duplex”。
我们正在推出Shizuku-Duplex,这是全球首个专为AI角色构建的全双工音频合成模型。了解我们的模型如何实现自然的人机交互:pic.twitter.com/IwinBs11h4
— Shizuku AI (@ShizukuAILabs) November 8, 2026
2-1. 基准测试结果
Shizuku AI 参考了 Full-Duplex-Bench 等,制作了日语基准测试,并与 GPT-Live、J-Moshi、LLM-jp-Moshi 等6个模型进行了比较。
主要结果如下:
・对话的自然度(Shizuku-Duplex / GPT-Live)
・通过附和继续说话的比例:95% / 88%
・不抢占对话间隙的比例:98% / 96%
・在2秒内因打断而停止的比例:89% / 82%
・响应时间(中位数):0.57秒 / 0.53秒
・响应内容的质量(Shizuku-Duplex / GPT-Live)
・多轮问答:79% / 95%
・使用网络搜索的回答:43% / 50%
・无搜索的问答:88% / 95%
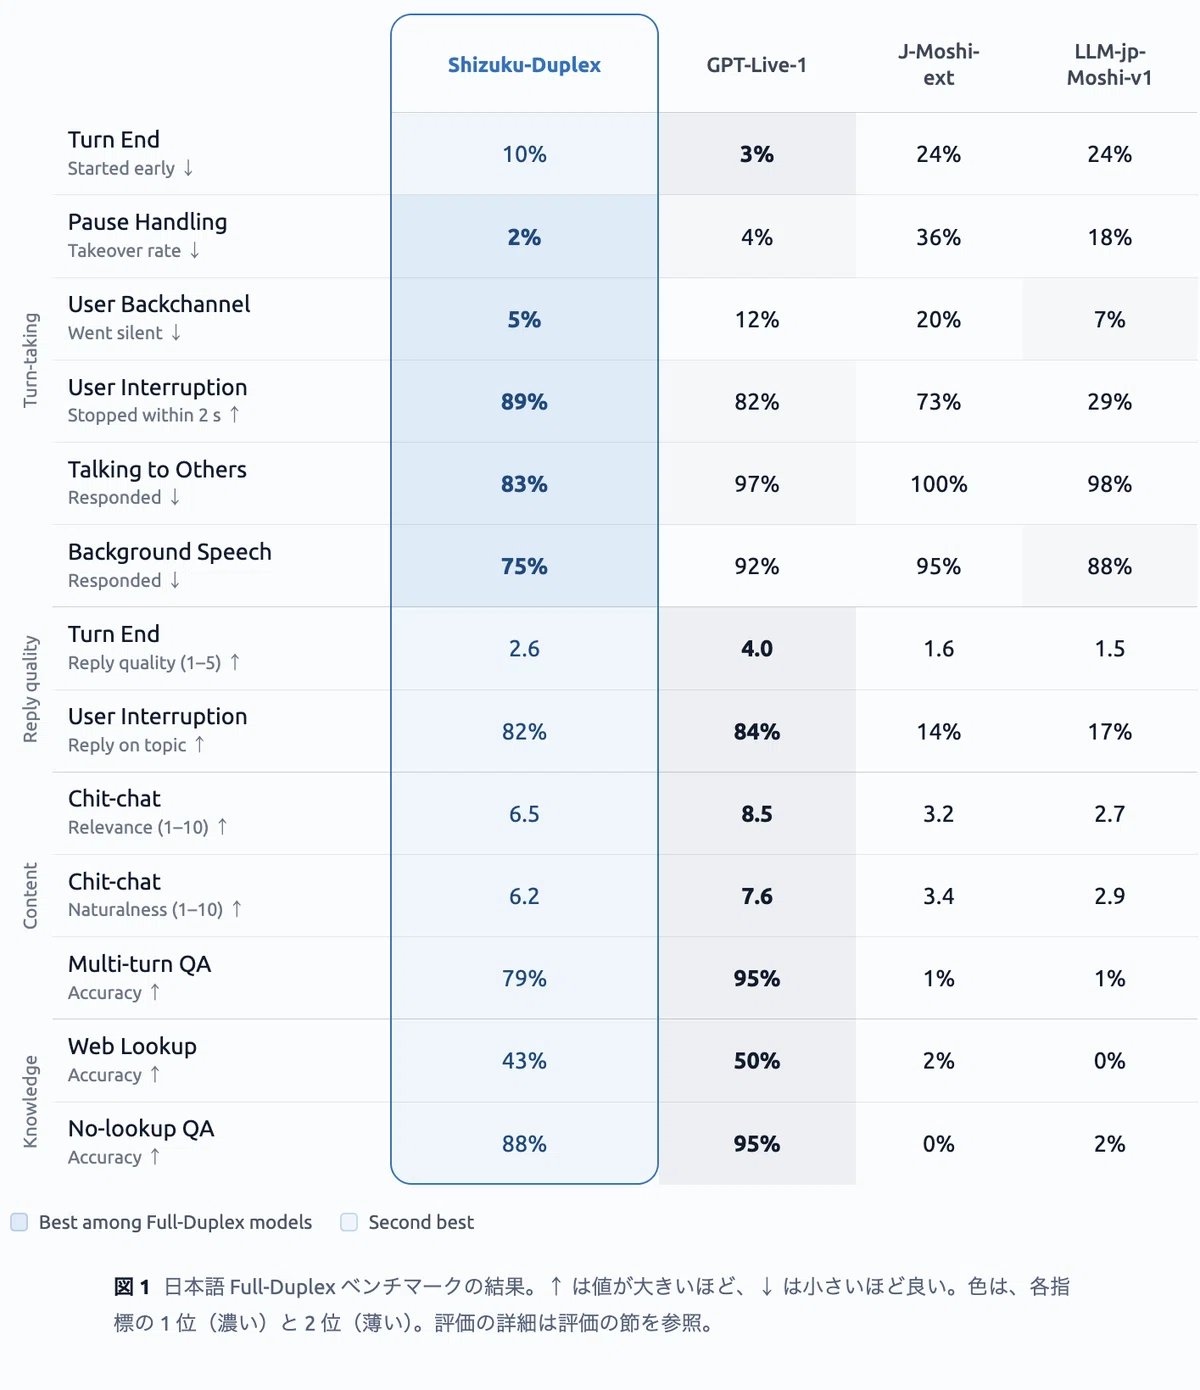
在点头回应、插话和发言时机的控制方面,Shizuku-Duplex 表现更优。 另一方面,在知识和问答质量方面,GPT-Live 更胜一筹,仍有改进空间。
2-2. Shizuku-Duplex 的工作原理
Shizuku-Duplex 每 80 毫秒处理一次用户语音,并生成 AI 语音。这使得模型能够自行判断何时开始说话以及何时保持沉默。
其主要特点如下:
・实时处理:以 80 毫秒周期进行语音输入和输出
・推理委托:在维持对话的同时,由另一个 LLM 执行搜索和复杂推理
・角色动作:根据说话时的情感选择 Live2D 动画
・长时间对话:大约每 5 分钟对对话历史进行摘要,压缩上下文
特别是,通过将对话与复杂推理交由不同模型处理,即使在执行 Web 搜索时也能继续对话。
Shizuku AI旨在利用这些技术,实现能够自然对话并表达情感的AI角色“しずく”。
3. 全双工语音对话模型是什么
3-1. 半双工与全双工
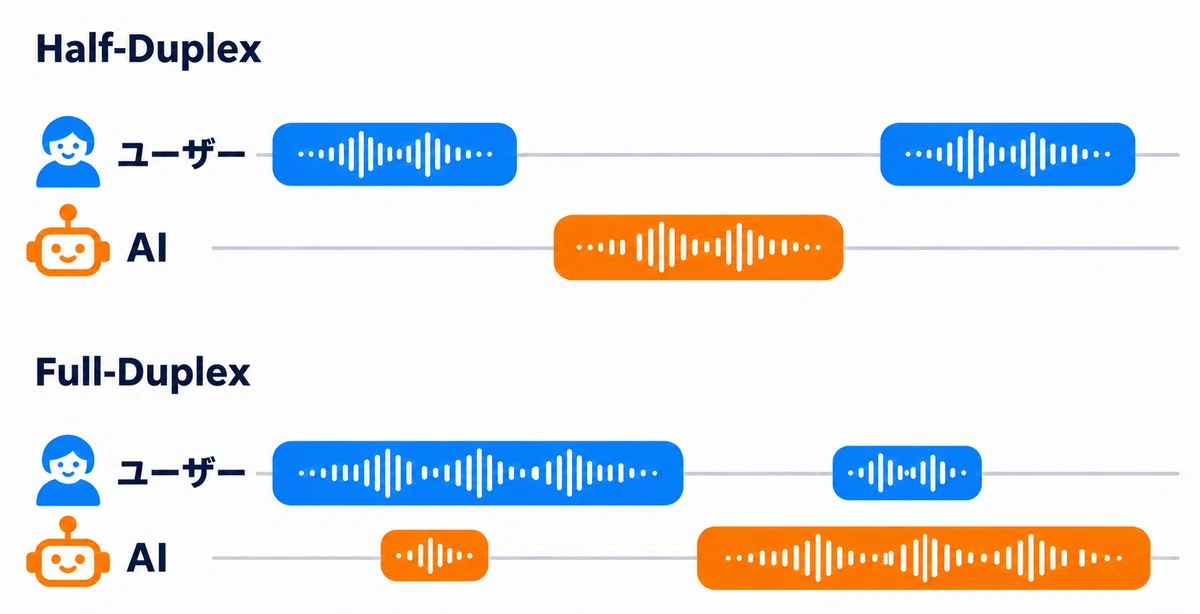
语音对话模型大致分为半双工(Half-Duplex)和全双工(Full-Duplex)两种。
・半双工:人类与AI交替发言的方式
・全双工:人类与AI在对方发言时也能处理声音,从而同时说话的方式
不仅仅是同时输入和输出声音,更重要的是根据对话情况判断说话、倾听或沉默的时机。
3-2. 全双工的工作机制
传统的语音AI通常采用主要经过以下三个阶段的“级联方式”进行处理。
・ASR(语音识别):将语音转换为文本
・LLM(语言模型):生成回复文本
・TTS(语音合成):将回复文本转换为语音
另一方面,在Moshi或Shizuku-Duplex等全双工语音对话模型中,系统会将用户的语音分割成短片段进行持续处理,同时生成AI的语音。
其主要技术如下。
・流式处理:将语音分割为短片段并逐个处理
・并行语音处理:并行处理用户语音输入与AI语音输出
・说话时机控制:判断附和、开始回应、中断发言等
・低延迟生成:以能够维持对话节奏的速度生成语音
例如,在Shizuku-Duplex中,以80毫秒为单位处理语音,并判断说话、倾听和沉默的时机。
这使得即使在用户讲话过程中也能回应附和,或在AI发言时被插话时调整响应。
此外,Full-Duplex并非必须由单一模型实现,也可以通过组合ASR、LLM、TTS等方式来实现。
4. Full-Duplex语音对话模型的历史
Full-Duplex语音对话模型是从旨在实现类人对话的语音AI研究中发展而来的。
4-1. 2018年:实现自然的语音对话
2018年5月,Google发布了“Google Duplex”。这是一个由AI代替人类为美容院和餐饮店进行电话预约的系统。
实现了类似人类的对话,包括附和与重新表述等。不过,它专注于预约等特定业务,与当前通用的全双工语音大语言模型(Full-Duplex Voice LLM)是不同的技术。
4-2. 2022〜2023年:直接处理语音的语言模型的登场
2022年出现了“dGSLM”,2023年则出现了“SpeechGPT”。
传统的语音AI主要采用语音识别(ASR)→语言模型(LLM)→语音合成(TTS)的三段式处理方式。
与此相对,将语音作为token进行处理、并由语言模型直接处理的研究取得了进展。特别是在dGSLM中,研究了处理话语重叠、附和等双向语音对话的技术。
4-3. 2024年:实时语音对话的进化
2024年5月,OpenAI发布了“GPT-4o”。它能够综合处理语音、图像和文本,对语音输入的平均响应时间为320毫秒,并支持在说话过程中进行打断。
7月,Kyutai发布了“Moshi”。这是一个开放的Full-Duplex语音LLM,能够在听取用户语音的同时生成AI语音。
由此,在持续处理语音的同时,能够应对附和与打断的实时对话受到了关注。
4-4. 2025年:日语支持与方式的多样化
2025年,Full-Duplex语音对话技术在日语支持、低延迟化以及结合多种模型的方式等方面呈现出多样化趋势。
主要模型和系统如下。
・J-Moshi:基于Moshi,支持日语的附和与话语重叠
・OmniFlatten:并行处理语音输入与输出,实现低延迟对话
・FireRedChat:结合语音识别、语音合成等技术,控制打断与说话时机
不仅限于单一的语音LLM,发展出了通过组合多个模型来实现全双工(Full-Duplex)的方式。
4-5. 2026年:实用化与对话质量提升
2026年,面向全双工语音对话模型的实用化改进取得了进展。
1月,NVIDIA发布了“PersonaPlex”。这是一个以Moshi为基础、可指定角色和声音的模型。
4月,字节跳动发布了“Seeduplex”。该模型重视在存在噪音或他人声音的环境中维持自然的对话。
7月,OpenAI发布了“GPT-Live”。它支持附和与插话,并能将复杂推理委托给另一个LLM。10月还推出了改进版“GPT-Live-1.1”。
随后在11月,Shizuku AI发布了“Shizuku-Duplex”。它不仅支持日语的自然附和与说话时机,还能表现角色的情感。
5. 全双工语音对话模型的未来挑战
全双工语音对话模型正在实现接近人类的自然对话,但仍存在一些课题。
主要课题如下:
・发言时机:理解对话流程,在合适的时机进行附和或发言
・多人对话:理解谁在对谁说话,仅在必要时参与对话
・应对噪音:不对周围的声音或无关的对话产生误反应
・长时间对话:持续听取对话,把握语境和话题的变化
今后,AI能够理解对话流程和情境,并在合适的时机做出自然回应将变得尤为重要。
随着这些技术的进步,预计人类与AI之间的对话将更加自然,语音AI的应用范围也将进一步扩大。
来源:npaka · AI与游戏开发技术 · note.com