vLLM 支持 PLE 的 SSD 卸载:DGX Spark 上实现 27GiB 内存节省
vLLM が PLE の SSDオフロード に対応 - DGX Spark で27GiBのメモリ削減
「vLLM」のPLEのSSDオフロード対応についてまとめました。
目次
- 1. はじめに
- 2. PLE と SSDオフロード の仕組み
- 2-1. PLEとは
- 2-2. なぜSSDに置けるのか
- 2-3. KVキャッシュとの違い
- 3. vLLM に追加された機能
- 4. DGX Spark での性能比較
- 4-1. メモリ使用量
- 4-2. トークン生成速度
- 5. Strataとの違い
1. はじめに
2026年10月30日、LLM推論エンジン「vLLM」に、巨大な埋め込みテーブルをSSDに配置して、メモリ使用量を削減する機能が追加されました。
これにより、DGX Sparkで「Qwen3.8-Flash-Next」を実行した際、メモリ使用量を27GiB削減しながら、トークン生成速度の低下を約3.5%に抑えることに成功しています。
SSDやRAMを活用してGPUメモリの使用量を抑える考え方は、少ないVRAMで巨大なMoEモデルを動かす推論エンジン「Strata」とも共通しています。
2. PLE と SSDオフロード の仕組み
2-1. PLEとは
「PLE」(Per-Layer Embedding)は、LLMが文章を処理する際、連続するトークンの組み合わせに対応する学習済みの情報を、巨大なテーブルから取り出し、特定の層の計算に利用する仕組みです。
たとえば「東京」「の」「天気」という3つのトークンに分割された場合、「東京+の」「の+天気」といった組み合わせをもとに、対応する数値データ(ベクトル)を取り出します。
辞書で言葉を調べるように、あらかじめ学習した情報を取り出してLLMの計算に利用する仕組みです。
PLEは、すべてのLLMに搭載されているわけではありません。
2-2. なぜSSDに置けるのか
Qwen3.8-Flash-NextのPLEには、数十GB規模の巨大なテーブルがあります。
しかし、文章を処理するたびにテーブル全体を使うわけではなく、必要なのはごく一部だけです。
これは、何万ページもある辞書から、必要な数ページだけを読むのに似ています。
そこで、テーブル全体をRAMやVRAMに読み込む代わりに、SSDに置いて必要な部分だけ取り出します。
これが「PLE の SSDオフロード」です。
SSDはRAMより低速ですが、必要な部分だけを読み込み、最近使ったデータはOSがRAMにキャッシュすることで、性能への影響を抑えられます。ただし、SSDの速度やキャッシュの状態によって性能は変わります。
2-3. KVキャッシュとの違い
PLEとKVキャッシュは、どちらもLLMの計算に利用するデータですが、役割が異なります。
PLEは学習済みの情報を取り出す仕組みで、KVキャッシュは処理済みのトークンに関する計算結果を再利用する仕組みです。
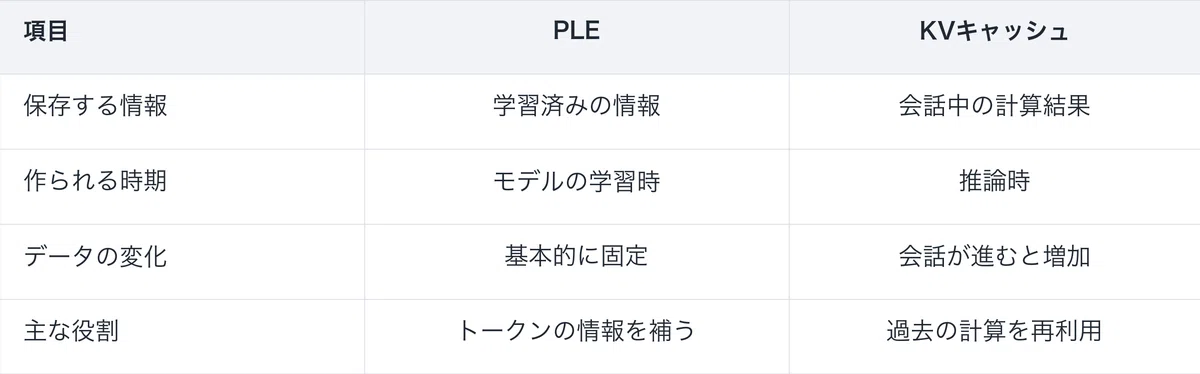
PLEはモデルに付属する「辞書」、KVキャッシュは会話中に作成される「作業メモ」のようなものです。
どちらもSSDに配置できますが、KVキャッシュは頻繁に参照されるため、速度低下が問題になりやすくなります。
3. vLLM に追加された機能
今回vLLMに追加されたのは、PLEテーブルをSSD上のモデルファイルに置いたまま、必要な部分だけ読み込む機能です。
主な特徴は次のとおりです。
・メモリ削減:PLEテーブル全体をRAMやVRAMに常駐させる必要がない
・SSDの活用:必要なデータだけを読み込む
・キャッシュの利用:読み込んだデータをOSがRAMに保持できる
・量子化対応:BF16・FP8・NVFP4に対応
・追加ファイル不要:元のモデルファイルをそのまま利用
現時点では、Qwen4Expアーキテクチャ向けのCUDA専用機能です。
4. DGX Spark での性能比較
vLLMの開発者は、DGX Spark(GB10)1台で「Qwen3.8-Flash-Next NVFP4」を実行して性能を検証しています。
4-1. メモリ使用量
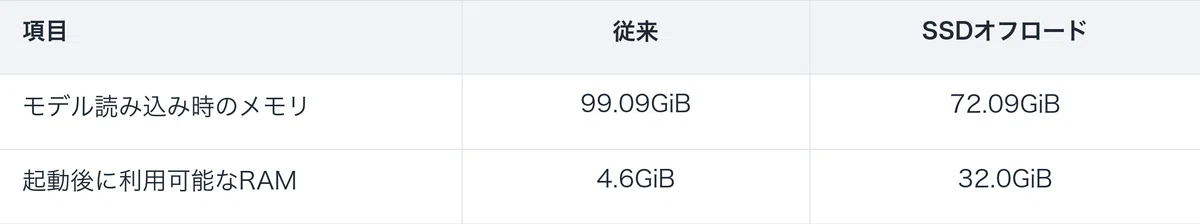
PLEテーブルをメモリに常駐させる方式と比べて、モデル読み込み時に計上されたメモリ量が99.09GiBから72.09GiBへと27.0GiB減少しました。また、起動後の利用可能なRAMも4.6GiBから32.0GiBへ増加しました。
DGX SparkはCPUとGPUがメモリを共有するため、この削減効果は特に重要です。
4-2. トークン生成速度
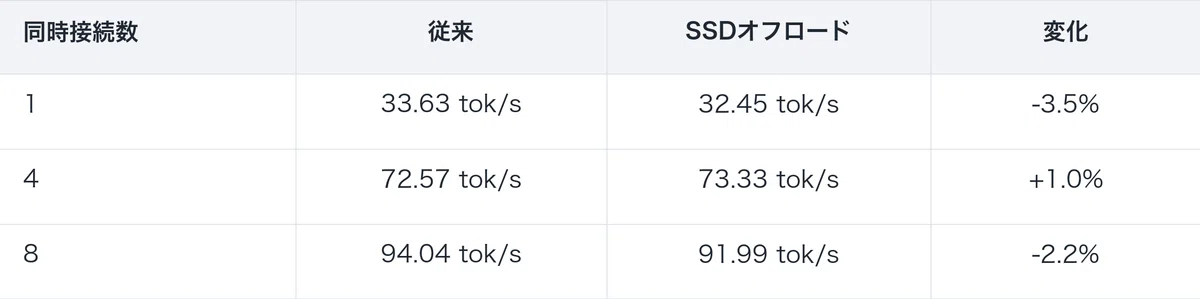
※ 1接続は1ユーザーの生成速度、4・8接続は全リクエストの合計生成速度です。いずれも生成処理中の速度であり、最初の応答までの待ち時間は含みません。
メモリを大幅に削減しながら、トークン生成速度はほぼ維持されています。
一方、8Kトークン入力時の最初のトークンが出るまでの時間(TTFT)は、2.54秒から2.82秒へ約11%増加しました。
SSDからの読み込みによって最初の応答は遅くなるものの、その後の文章生成速度への影響は小さいという結果です。ただし、モデルファイルを低速なストレージに置く場合は、応答の遅延が大きくなる可能性があります。
※ 性能はSSDの速度やキャッシュ状態によって変わります。
5. Strataとの違い
今回の機能はStrataの仕組みに似ていますが、StrataそのものがvLLMに統合されたわけではありません。
Strataは、GPU・RAM・SSDを組み合わせて巨大なMoEモデルを動かす推論エンジンです。
特に、MoEの「Expert(専門家)」と呼ばれる計算用の重みを、GPUとRAMの間で効率的に管理します。
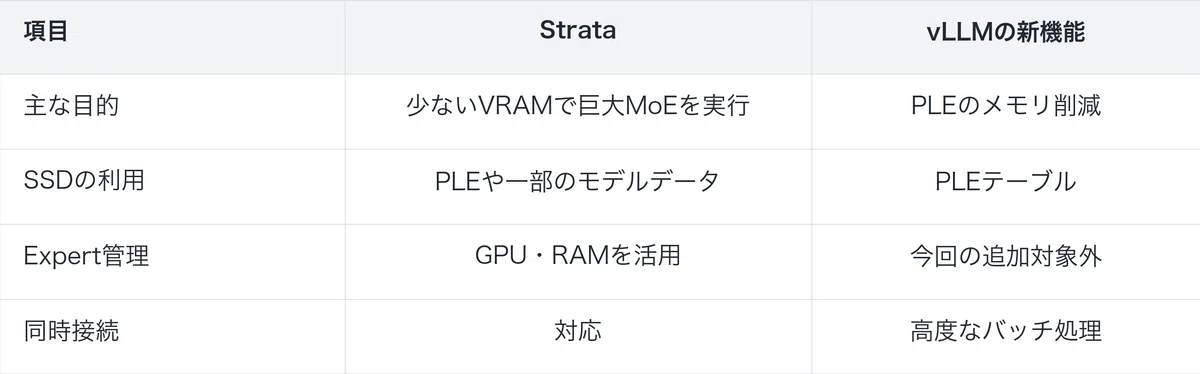
Strataは巨大モデル全体のメモリ管理、今回のvLLMの新機能はPLEテーブルのメモリ削減を重視しています。
そのため、今回の対応だけでvLLMがStrataと同じように、VRAM 12GB・RAM 64GBのPCで巨大MoEモデルを動かせるわけではありません。
6. vLLMでの使い方
対応するvLLMのビルドでは、次のオプションでPLEのSSDオフロードを有効化できます。
vllm serve <対応モデル> --engram-config '{"disk_offload": true}'disk_offloadをtrueにすると、PLEテーブルをSSD上のモデルファイルから必要に応じて読み込みます。
高速なNVMe SSDが推奨されます。
2026年11月2日時点では、この機能を含むvLLMのmainブランチなど、対応するビルドが必要です。
7. まとめ
今回のvLLMの新機能で重要なのは、LLMの巨大なデータをすべてメモリに読み込む必要はないという考え方です。
PLEのように一部のデータだけを参照する仕組みであれば、SSDに保存したまま必要な部分だけ読み込めます。
その結果、DGX Sparkでは27GiBのメモリ削減と、ほぼ同等のトークン生成速度を両立できました。
今回のSSDオフロード機能はPLE専用ですが、MoEのExpertについても、GPU・RAM・SSDを効率的に活用する技術の発展が期待されます。
StrataやvLLMの進化によって、少ないGPUメモリで巨大なLLMを実用的に動かす技術がさらに発展することが期待されます。
来源:npaka · AI与游戏开发技术 · note.com