vLLM 支持 PLE 的 SSD 卸载:DGX Spark 上实现 27GiB 内存节省
vLLM が PLE の SSDオフロード に対応 - DGX Spark で27GiBのメモリ削減
总结了vLLM的PLE对SSD卸载的支持。
目次
- 1. 前言
- 2. PLE与SSD卸载的机制
- 2-1. 什么是PLE
- 2-2. 为什么放置在SSD上
- 2-3. 与KV缓存的区别
- 3. vLLM 新增功能
- 4. DGX Spark 上的性能对比
- 4-1. 内存使用情况
- 4-2. Token 生成速度
- 5. 与 Strata 的区别
1. 前言
2026年10月30日,LLM推理引擎"vLLM"新增了将大型嵌入表放置在SSD上以降低内存使用量的功能。
借此,在DGX Spark上运行"Qwen3.8-Flash-Next"时,成功实现了在减少27GiB内存占用的同时,将令牌生成速度的下降幅度控制在约3.5%。
利用SSD和RAM来抑制GPU内存使用量的思路,也与旨在以少量VRAM运行大型MoE模型的推理引擎"Strata"的理念相通。
2. PLE与SSD卸载的机制
2-1. 什么是PLE
"PLE"(Per-Layer Embedding,逐层嵌入)是一种机制:当LLM处理文本时,它从大型表中检索与连续令牌组合相对应的预训练信息,并将其用于特定层的计算。
例如,当被分割为“东京”、“の”、“天气”这三个token时,系统会基于“东京+の”、“の+天气”等组合,提取对应的数值数据(向量)。
这是一种机制:像查字典一样,预先提取已学习的信息并用于LLM的计算。
PLE并非搭载于所有LLM中。
2-2. 为什么要放在SSD上
Qwen3.8-Flash-Next的PLE包含一个规模达数百GB的巨大表格。
然而,处理文章时并不会使用整个表格,真正需要的只是其中极小部分。
这类似于从数万页的字典中仅阅读所需的那几页。
因此,与其将整个表格加载到RAM或VRAM中,不如将其放置在SSD上,仅提取所需部分。
这就是“PLE 的 SSD 卸载”。
SSD的速度虽慢于RAM,但通过仅读取所需部分,并由操作系统将最近使用的数据缓存至RAM,可以抑制对性能的影响。不过,性能会根据SSD的速度和缓存状态而有所不同。
2-3. 与KV缓存的区别
PLE和KV缓存都是用于LLM计算的数据,但它们的角色不同。
PLE是一种提取已训练信息的机制,而KV缓存是一种复用已处理token相关计算结果的机制。
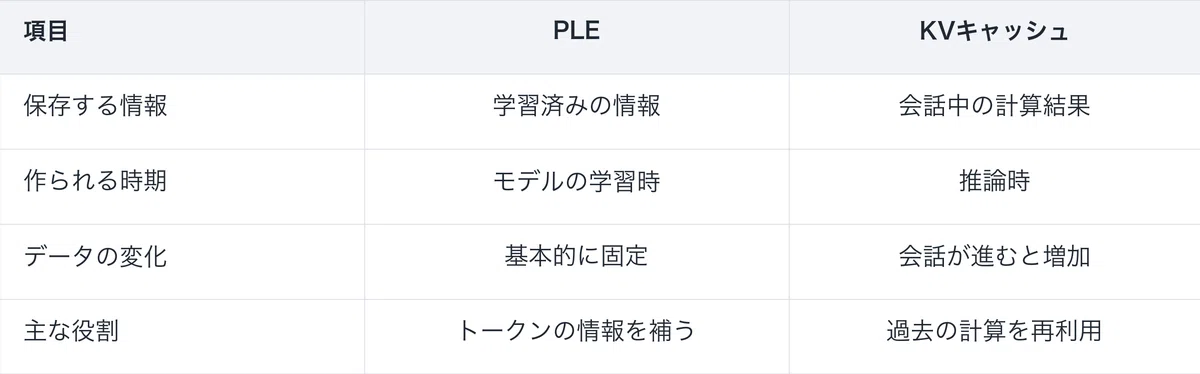
PLE类似于模型附带的“词典”,而KV缓存则类似于对话过程中创建的“工作笔记”。
两者都可以放置在SSD上,但由于KV缓存会被频繁引用,因此更容易出现速度下降的问题。
3. vLLM新增的功能
本次vLLM新增的功能是将PLE表保留在SSD上的模型文件中,仅按需读取所需部分。
主要特点如下。
・内存占用减少:无需将PLE表常驻于RAM或VRAM中
・利用SSD:仅读取所需数据
・利用缓存:操作系统可将已读取的数据保留在RAM中
・支持量化:兼容BF16、FP8和NVFP4
・无需额外文件:直接使用原始模型文件
目前,这是专为Qwen4Exp架构提供的CUDA功能。
4. DGX Spark上的性能对比
vLLM的开发人员正在使用一台DGX Spark(GB10)运行“Qwen3.8-Flash-Next NVFP4”以验证其性能。
4-1. 内存使用情况
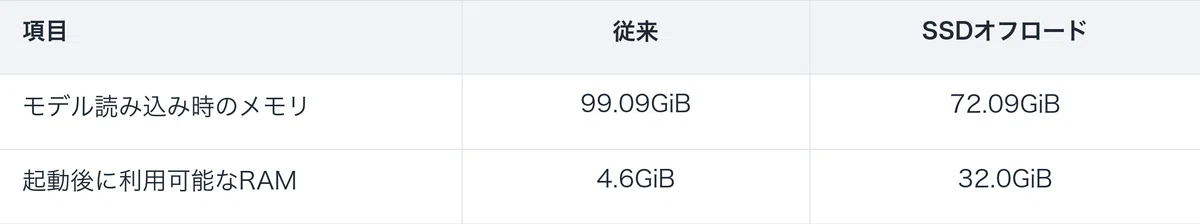
与将PLE表常驻内存的方式相比,模型加载时记录的内存量从99.09GiB减少至72.09GiB,减少了27.0GiB。此外,启动后可用的RAM也从4.6GiB增加到了32.0GiB。
由于DGX Spark的CPU和GPU共享内存,因此这种削减效果尤为重要。
4-2. 令牌生成速度
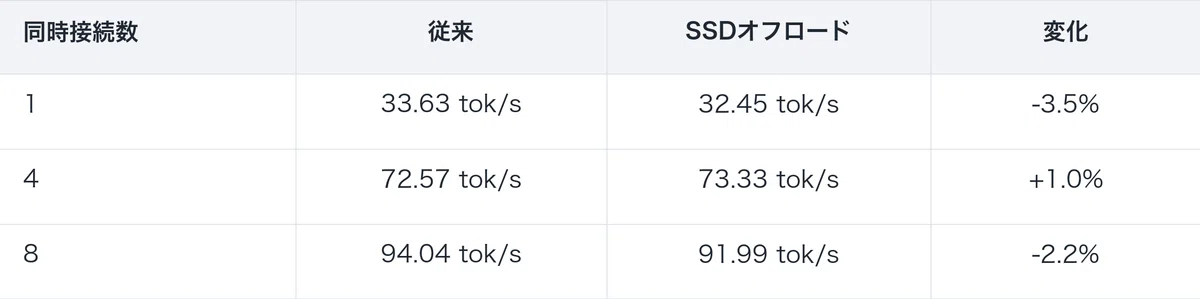
※ 1连接表示单个用户的生成速度,4连接和8连接表示所有请求的总生成速度。均为生成处理过程中的速度,不包含首次响应的等待时间。
在大幅减少内存占用的同时,令牌生成速度基本保持不变。
另一方面,当输入为8K令牌时,首个令牌出现的时间(TTFT)从2.54秒增加到2.82秒,增幅约为11%。
结果表明,虽然从SSD读取会导致首次响应变慢,但对后续文本生成速度的影响较小。不过,如果将模型文件放置在低速存储设备上,可能会导致响应延迟显著增加。
※ 性能取决于SSD的速度及缓存状态。
5. 与Strata的区别
本次功能与Strata的机制类似,但Strata本身并未集成到vLLM中。
Strata是一个结合GPU、RAM和SSD来运行大型MoE模型的推理引擎。
特别是,它高效地管理被称为“专家(Expert)”的计算权重在GPU和RAM之间的分配。
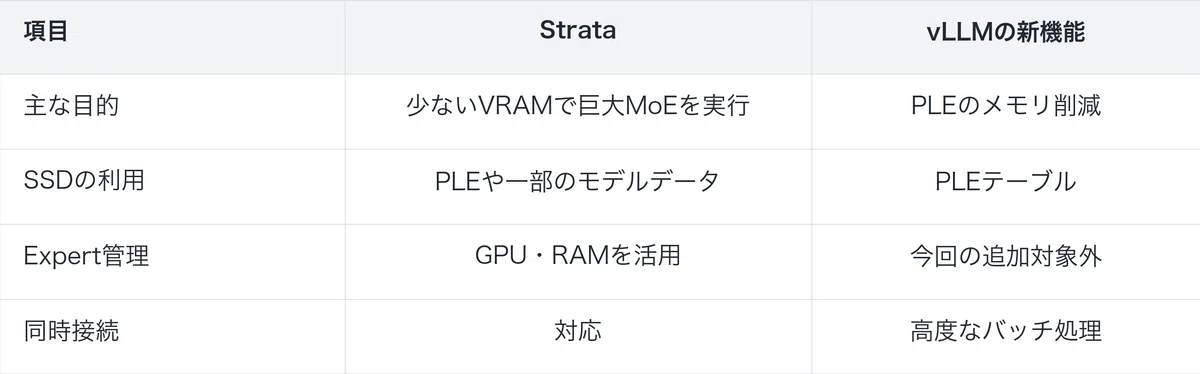
Strata侧重于整个大模型的内存管理,而本次vLLM的新功能则侧重于减少PLE表的内存占用。
因此,仅凭本次更新,vLLM并不能像Strata那样在VRAM为12GB、RAM为64GB的PC上运行大型MoE模型。
6. 在vLLM中的使用方法
在对应的vLLM构建版本中,可以通过以下选项启用PLE的SSD卸载功能。
vllm serve <対応モデル> --engram-config '{"disk_offload": true}'将disk_offload设置为true时,PLE表会根据需要从位于SSD上的模型文件中加载。
推荐使用高速NVMe SSD。
截至2026年11月2日,需要包含此功能的vLLM main分支等对应构建版本。
7. 总结
本次vLLM新功能的关键在于无需将所有庞大的LLM数据全部加载到内存中这一理念。
对于像PLE这样仅引用部分数据的机制,可以保持数据存储在SSD上,仅按需读取所需部分。
因此,在DGX Spark上实现了减少27GiB内存占用且几乎保持同等令牌生成速度的效果。
本次SSD卸载功能专用于PLE,但预计MoE的Expert也将迎来GPU、RAM和SSD高效利用技术的发展。
随着Strata和vLLM的进步,在少量GPU内存下实用运行大型LLM的技术有望进一步发展。
来源:npaka · AI与游戏开发技术 · note.com