MIT CSAIL发布Weight-Space Programming:GPT-6 Astra直接解析与编辑神经网络权重
Weight-Space Programming の概要 - GPT-6 Astraがニューラルネットワークの重みを直接解析・編集・生成
MIT CSAIL提出Weight-Space Programming,GPT-6 Astra可直接读写神经网络权重,无需训练即可生成或修复AI。
「Weight-Space Programming」的概要总结如下。
目次
- 1. Weight-Space Programming
- 2. Read - 从权重推测AI的学习内容
- 2-1. 从游戏AI的权重中识别游戏
- 2-2. 从图像生成AI的权重中识别生成内容
- 2-3. 从语言模型的权重中识别学习语言
- 3. 修复 - 通过重写权重来改善AI性能
- 3-1. 修正在PPO中失败的遊戲AI
- 3-2. 改善Qwen3.5-0.8B的数学能力
- 4. 编写 - 无需学习即可生成AI权重
- 4-1. 生成比PPO性能更高的游戏AI
1. 权重空间编程
2026年11月2日,MIT CSAIL的研究团队发布了一种名为“Weight-Space Programming”的新方法,该方法允许大型语言模型(LLM)直接读写神经网络的权重。
神经网络的“权重”是指决定AI行为的大量数值。通常,这些数值是通过使用大量数据进行学习并逐步调整得到的。
学习数据 → 误差计算 → 重复学习 → 权重更新
另一方面,在Weight-Space Programming中,LLM会推断权重的作用并直接进行重写。
自然语言指令 → LLM推理 → 权重的直接编辑
研究中使用了通用LLM“GPT-6 Astra”,验证了以下三项能力。
・Read:分析权重,推测AI学习了什么
・Fix:发现AI的问题,重写权重以进行改进
・Write:无需学习,从零开始创建AI的权重
具体而言,我们成功实现了以下目标:
・读取权重:仅凭权重即可识别游戏AI的类型
・修正权重:解决LLM的重复问题,提升数学能力
・生成权重:无需训练即可创建游戏AI
这表明,LLM能够直接检查、修改或从头创建权重,而无需依赖以往那种基于大量数据的重新训练或梯度下降法。
2. Read - 从权重中推测AI的学习内容
2-1. 从游戏AI的权重中识别游戏
我们使用强化学习算法“PPO”对简化版的Breakout、Pong、Pac-Man和Freeway这4种游戏AI进行了训练。这4个AI均采用相同的结构,向Astra提供了17,253个权重参数,以及仅隐藏了游戏名称的输入输出说明。
结果,Astra在未实际运行游戏的情况下,正确识别出了全部4种游戏。
2-2. 从图像生成AI的权重中识别生成内容
我们准备了一个用于生成圆形、三角形和四边形的轻量级图像生成AI(DDPM),并让Astra分析其各自的权重。
结果,Astra正确识别出了每个AI所生成的图形种类。
不过,实际的AI生成的是填充图形,而Astra推断出的仅是轮廓。也就是说,Astra虽然能够推测出生成内容的大致类型,但并未精确掌握到细节层面。
2-3. 言語モデルの重みから学習言語を特定
Pythonコード、ローマ字の日本語、英語をそれぞれ学習した、約720万パラメータの言語モデルを用意しました。Astraには、入力層と出力層を除いた中間部分の重みだけを渡しました。
その結果、3種類すべての学習言語を正しく特定しました。さらに、過去に登場した文字列のパターンを利用して続きを予測する「Induction Head」という仕組みも発見しました。
3. Fix - 重みを書き換えてAIの性能を改善
3-1. PPOで失敗したゲームAIを修正
物理シミュレーション環境「Kinetix」で、車を操作して障害物を越えるゲームを用意しました。
PPOで10億ステップ学習したAIは、坂を登りきれずに停止してしまいます。そこでAstraは、AIの重みと失敗時の動きを分析し、一度バックして助走をつける方法を考え、その動作ができるように重みを修正しました。
结果,仅通过一次编辑修改约3.5%的权重,成功率就从0%提升到了100%(经过1,024次评估)。
3-2. 改善Qwen3.5-0.8B的数学能力
语言模型“Qwen3.5-0.8B”存在一个名为“Thinking Loop”的问题,即在推理过程中会重复相同内容,导致无法结束回答。
Astra通过分析练习题找到了原因,并直接修正了第24层中的第15层和第19层的权重。此次变更仅占整个模型权重的0.016%。
结果,数学问题(MATH-500)的正确率从7.9%提升至48.1%,遵循指令的能力也得到了提高。
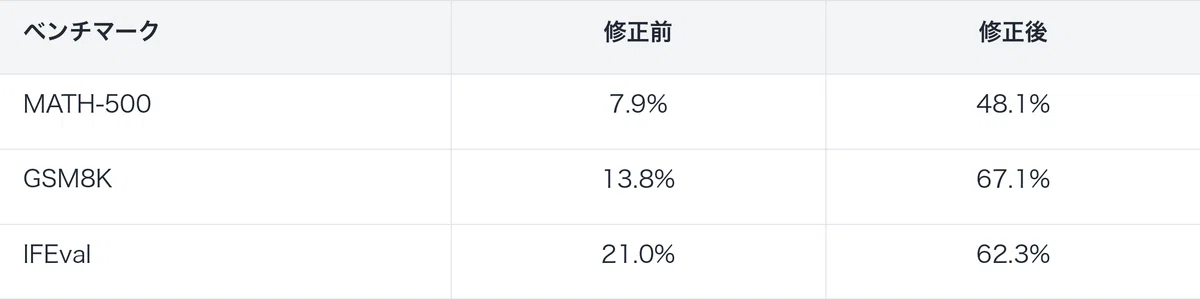
不过,与其说是获得了新的数学能力,不如说主要是解决了因重复相同内容而无法完成回答的问题。
4. Write - 无需学习即可生成AI权重
4-1. PPOより高性能なゲームAIを生成
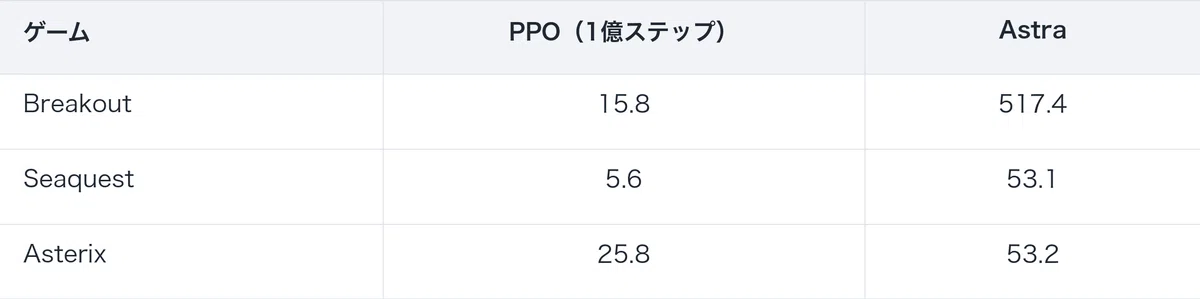
Astraにゲームのルールとニューラルネットワークの構造を教え、学習を行わずに重みをゼロから作成させました。対象は、シンプルなゲーム環境「MinAtar」のBreakout、Seaquest、Asterixです。
この実験では、学習データや勾配降下法を使わず、生成したAIを試しにプレイさせて結果を確認することもしていません。
その結果、3種類すべてで、1億ステップ学習したPPOより高いスコアを記録しました。ただし、5億ステップ学習したPPOとの比較では、Breakoutのみ上回りました。
4-2. 囲碁AIの重みを生成
さらに、約148万パラメータのニューラルネットワークで、9×9の囲碁をプレイするAIも作成しました。AstraはPythonを使い、石の配置や取られる危険性を判断する仕組みを考え、重みに直接組み込みました。
その結果、最大50回のForward Pass(モデルの実行)と動作確認を通じて、2,000万ゲーム学習した同規模のPPOモデルを上回る性能を達成しました。
ただし、比較相手は研究用のPPOモデルであり、一般的な強豪囲碁AIを上回ったわけではありません。
5. 現在の限界
今回の研究は初期段階であり、次のような制約があります。
・大規模モデル:すべての重みをLLMのコンテキストに収めることは困難
・汎用性:すべてのモデルやタスクで成功するわけではない
・能力の追加:問題を修正できても、新しい能力を獲得できるとは限らない
・再現性:評価環境やツールの設計によって結果が変わる可能性がある
例えば、Gemma 3 270Mの数学性能を改善する実験では、重みの修正はほとんど効果がありませんでした。
また、ユーザーの意見に過度に同調するモデルを重みだけで見分ける実験にも失敗しています。ただし、モデル実行時のAttention(注意の向け方)の情報を追加すると判別に成功しました。
6. 今後の可能性
Weight-Space Programmingが発展すると、次のような応用が期待されます。
・モデルの監査:重みからバックドアや危険な振る舞いを発見
・学習コストの削減:再学習せずに特定の問題を修正
・能力の編集:特定の知識や振る舞いを追加・削除
・自己改善:AIが自身の重みを解析して改善
・モデルの統合:異なるモデルの機能を組み合わせる
ただし、これらは今後の研究課題であり、すべてが実証されたわけではありません。
関連
来源:npaka · AI与游戏开发技术 · note.com